AI Dubbing ทำงานอย่างไร: เทคโนโลยีเบื้องหลังการแปลเสียง




เครื่องมือแปลวิดีโอ AI การทำให้เข้าท้องถิ่น และการพากย์เสียง
ลองใช้งานฟรี
AI dubbing แปลงเสียงวิดีโอจากภาษาหนึ่งเป็นอีกภาษาหนึ่งผ่านไปป์ไลน์ 4 ขั้นตอน: การรู้จำเสียง การแปลด้วยนิวรอล การสังเคราะห์เสียง และการจัดเรียงการซิงค์ปาก แพลตฟอร์มอย่าง Perso Dubbing ทำกระบวนการนี้เสร็จภายในประมาณ 3 นาที แทนที่เวิร์กโฟลว์แบบดั้งเดิมที่ใช้เวลาหลายวันหรือหลายสัปดาห์กับนักพากย์ วิศวกรเสียง และทีมโพสต์โปรดักชัน
บทความนี้อธิบายแต่ละขั้นตอนของไปป์ไลน์ AI dubbing อธิบายเทคโนโลยีที่ขับเคลื่อนมัน และแสดงให้เห็นว่าความแตกต่างด้านคุณภาพเกิดขึ้นที่ไหนระหว่างเครื่องมือต่างๆ
จากสตูดิโอแบบแมนนวลสู่ไปป์ไลน์อัตโนมัติ
การพากย์แบบดั้งเดิมต้องจ้างนักพากย์สำหรับทุกภาษาเป้าหมาย จัดเซสชันบันทึกเสียงในสตูดิโอเก็บเสียง ปรับจังหวะด้วยมือให้ตรงกับการขยับปาก และผสมเสียงขั้นสุดท้ายอย่างละเอียด วิดีโอ 10 นาทีเพียงชิ้นเดียวที่พากย์เป็น 5 ภาษาอาจใช้เวลา 2-4 สัปดาห์และมีค่าใช้จ่ายหลายพันดอลลาร์
AI dubbing แทนที่สิ่งนี้ด้วยไปป์ไลน์อัตโนมัติที่จัดการทั้ง 4 ขั้นตอน — การถอดเสียง การแปล การสร้างเสียง และการซิงค์ปาก — ในการประมวลผลครั้งเดียว ผลลัพธ์คือวิดีโอที่พากย์แล้วซึ่งรักษาคุณลักษณะเสียงของผู้พูดดั้งเดิม ทำให้ครีเอเตอร์สามารถแปลวิดีโอเป็นกว่า 99 ภาษาจากการอัปโหลดเพียงครั้งเดียว
สำหรับภาพรวมที่กว้างขึ้นเกี่ยวกับ AI dubbing คืออะไรและควรใช้เมื่อไหร่ ดูคู่มือ AI dubbing ฉบับสมบูรณ์ของเรา
ไปป์ไลน์ AI dubbing 4 ขั้นตอน
แพลตฟอร์ม AI dubbing ทุกแห่งใช้สถาปัตยกรรมพื้นฐานเดียวกัน แม้ว่าการใช้งานจริงจะแตกต่างกันในด้านคุณภาพและความสามารถ ต่อไปนี้คือวิธีการทำงานของแต่ละขั้นตอน

ขั้นตอนที่ 1: การรู้จำเสียง (ASR / STT)
ไปป์ไลน์เริ่มต้นด้วยการรู้จำเสียงอัตโนมัติ (ASR) หรือที่เรียกว่า speech-to-text (STT) ขั้นตอนนี้แปลงแทร็กเสียงต้นฉบับเป็นข้อความที่มีการประทับเวลา
สิ่งที่เกิดขึ้นในทางเทคนิค:
เสียงถูกแยกออกจากเพลงประกอบและเอฟเฟกต์เสียงโดยใช้อัลกอริทึมแยกแหล่งที่มา (การแยกเสียงร้อง)
โมเดลรู้จำเสียงถอดคำพูดเป็นข้อความ รองรับสำเนียง ภาษาถิ่น และศัพท์เฉพาะทาง
การแยกผู้พูด (diarization) ระบุและติดป้ายผู้พูดต่างๆ ในวิดีโอหลายผู้พูด
แต่ละคำหรือวลีได้รับการประทับเวลาที่แม่นยำ รักษาจังหวะต้นฉบับ
ทำไมจึงสำคัญต่อคุณภาพ: ข้อผิดพลาดในขั้นตอนนี้ส่งผลกระทบเป็นลูกโซ่ตลอดทั้งไปป์ไลน์ คำที่ถอดเสียงผิดกลายเป็นประโยคที่แปลผิด ซึ่งกลายเป็นเสียงพากย์ที่ไม่ถูกต้อง เอนจินรู้จำเสียงของ Perso Dubbing รองรับ 100 ภาษาเป็นอินพุต หมายความว่าแทบทุกภาษาต้นทางสามารถเข้าสู่ไปป์ไลน์ได้
ขั้นตอนที่ 2: การแปลด้วยเครื่องแบบนิวรอล (NMT)
ข้อความที่ถอดเสียงพร้อมประทับเวลาจะเข้าสู่ขั้นตอนการแปล ซึ่งโมเดลการแปลด้วยเครื่องแบบนิวรอลจะแปลงข้อความเป็นภาษาเป้าหมาย
อะไรที่ทำให้การแปลสำหรับพากย์แตกต่างจากการแปลข้อความ:
การจับคู่ความยาว: ประโยคที่แปลแล้วต้องมีระยะเวลาใกล้เคียงกับคำพูดต้นฉบับ วลีภาษาอังกฤษ 3 วินาทีที่แปลเป็นภาษาเยอรมันอาจใช้เวลาพูด 5 วินาที — โมเดลแปลต้องบีบอัดหรือปรับโครงสร้างใหม่ให้พอดี
ความเหมาะสมในการพูด: การแปลแบบเขียนมักฟังดูไม่เป็นธรรมชาติเมื่ออ่านออกเสียง โมเดล NMT ที่ปรับให้เหมาะกับการพากย์จะสร้างเอาต์พุตแบบสนทนาที่เหมาะสำหรับการสังเคราะห์เสียง
การรักษาบริบท: คำศัพท์เทคนิค ชื่อเฉพาะ และการอ้างอิงทางวัฒนธรรมต้องการการจัดการที่รักษาความหมายโดยไม่ใช้การแปลคำต่อคำแบบตรงตัว
การจัดเรียงประทับเวลา: แต่ละเซกเมนต์ที่แปลแล้วจะสืบทอดข้อจำกัดด้านเวลาจากต้นฉบับ เพื่อให้แน่ใจว่าเสียงพากย์ตรงกับสัญญาณภาพบนหน้าจอ
แพลตฟอร์ม AI dubbing สมัยใหม่ใช้โมเดลภาษาขนาดใหญ่ที่ปรับแต่งเฉพาะสำหรับการแปลภาษาพูด ไม่ใช่ตัวแปลข้อความแบบทั่วไป ความแตกต่างนี้สำคัญมากสำหรับเอาต์พุตที่ฟังดูเป็นธรรมชาติ
ขั้นตอนที่ 3: การสังเคราะห์และโคลนเสียง (TTS)
ขั้นตอนนี้คือจุดที่ข้อความที่แปลแล้วกลายเป็นเสียงพูด เอนจิน text-to-speech (TTS) สร้างเสียงพูดในภาษาเป้าหมายพร้อมรักษาคุณลักษณะเสียงของผู้พูดดั้งเดิม
เทคโนโลยีเบื้องหลังการรักษาเสียง:
การโคลนเสียง: ระบบวิเคราะห์เสียงของผู้พูดดั้งเดิม — ระดับเสียง สีสันเสียง จังหวะการพูด และโทนอารมณ์ — จากนั้นสร้างเสียงพูดใหม่ที่ฟังดูเหมือนคนเดิมพูดภาษาอื่น
การถ่ายโอนทำนองเสียง: นอกเหนือจากเสียงพูดแล้ว ระบบยังถ่ายโอนรูปแบบการพูด: การเน้น จังหวะหยุด เส้นโค้งทำนองเสียง และความเร็ว
การจับคู่อารมณ์: โมเดลขั้นสูงตรวจจับสถานะอารมณ์ในเสียงต้นทาง (ความตื่นเต้น ความกังวล อารมณ์ขัน) และจำลองมันในเอาต์พุตที่สังเคราะห์
Perso Dubbing ใช้ ElevenLabs V3 เอนจินสังเคราะห์เสียงที่สร้างเสียงพูดที่ฟังดูเป็นธรรมชาติพร้อมรักษาอัตลักษณ์เสียงของผู้พูดดั้งเดิม ผู้ใช้สามารถปรับแต่งเอาต์พุตเพิ่มเติมผ่านตัวเลือก VoiceTone ซึ่งช่วยให้ครีเอเตอร์ปรับแต่งคุณลักษณะโทนเสียงอย่างละเอียดสำหรับประเภทเนื้อหาเฉพาะ — ไม่ว่าจะเป็นบรรยายด้านการศึกษา วิดีโอการตลาด หรือเนื้อหาบันเทิง
การจัดการหลายผู้พูด: ในวิดีโอที่มีผู้พูดหลายคน แต่ละเสียงจะถูกโคลนและสังเคราะห์แยกกัน ไปป์ไลน์รักษาโปรไฟล์เสียงที่แตกต่างกันตลอดทั้งกระบวนการ ดังนั้นการสนทนาระหว่างสองคนจะฟังดูเหมือนคนสองคนในเวอร์ชันที่พากย์แล้ว
ขั้นตอนที่ 4: การจัดเรียงการซิงค์ปาก
ขั้นตอนสุดท้ายจัดการกับความสอดคล้องของภาพ เมื่อเสียงพากย์มีความยาวหรือจังหวะแตกต่างจากต้นฉบับ การขยับปากของผู้พูดจะไม่ตรงกับสิ่งที่ผู้ชมได้ยินอีกต่อไป
เทคโนโลยีซิงค์ปากทำงานอย่างไร:
โมเดล computer vision วิเคราะห์การเคลื่อนไหวใบหน้าของผู้พูดทีละเฟรม ระบุรูปทรงปาก (visemes) และจังหวะ
ระบบปรับจังหวะเสียงที่สังเคราะห์ให้ตรงกับการขยับปากที่มีอยู่ หรือปรับเปลี่ยนบริเวณใบหน้าของวิดีโอให้ตรงกับเสียงใหม่
เสียงพื้นหลัง (เพลง เสียงแวดล้อม เอฟเฟกต์) ถูกรักษาไว้และผสมกลับเข้ากับแทร็กเสียงพากย์
Perso Dubbing ประมวลผลการพากย์พร้อมซิงค์ปากโดยอัตโนมัติเป็นส่วนหนึ่งของเวิร์กโฟลว์การพากย์ — ไม่มีขั้นตอนแยกหรือค่าใช้จ่ายเพิ่มเติม นี่เป็นจุดแตกต่างที่สำคัญ เนื่องจากบางแพลตฟอร์มเรียกเก็บค่าใช้จ่ายเพิ่มสำหรับการประมวลผลซิงค์ปากหรือไม่มีให้บริการเลย สำหรับคู่มือเชิงลึกเกี่ยวกับการทำซิงค์ปากให้เป็นธรรมชาติ ดูคู่มือของเราเกี่ยวกับวิธีทำซิงค์ปากที่สมบูรณ์แบบด้วย AI dubbing
อะไรที่แยก AI dubbing ที่ดีจากที่แย่
ไม่ใช่ทุกไปป์ไลน์ AI dubbing จะให้ผลลัพธ์เท่ากัน ความแตกต่างด้านคุณภาพมักปรากฏใน 5 ด้าน:
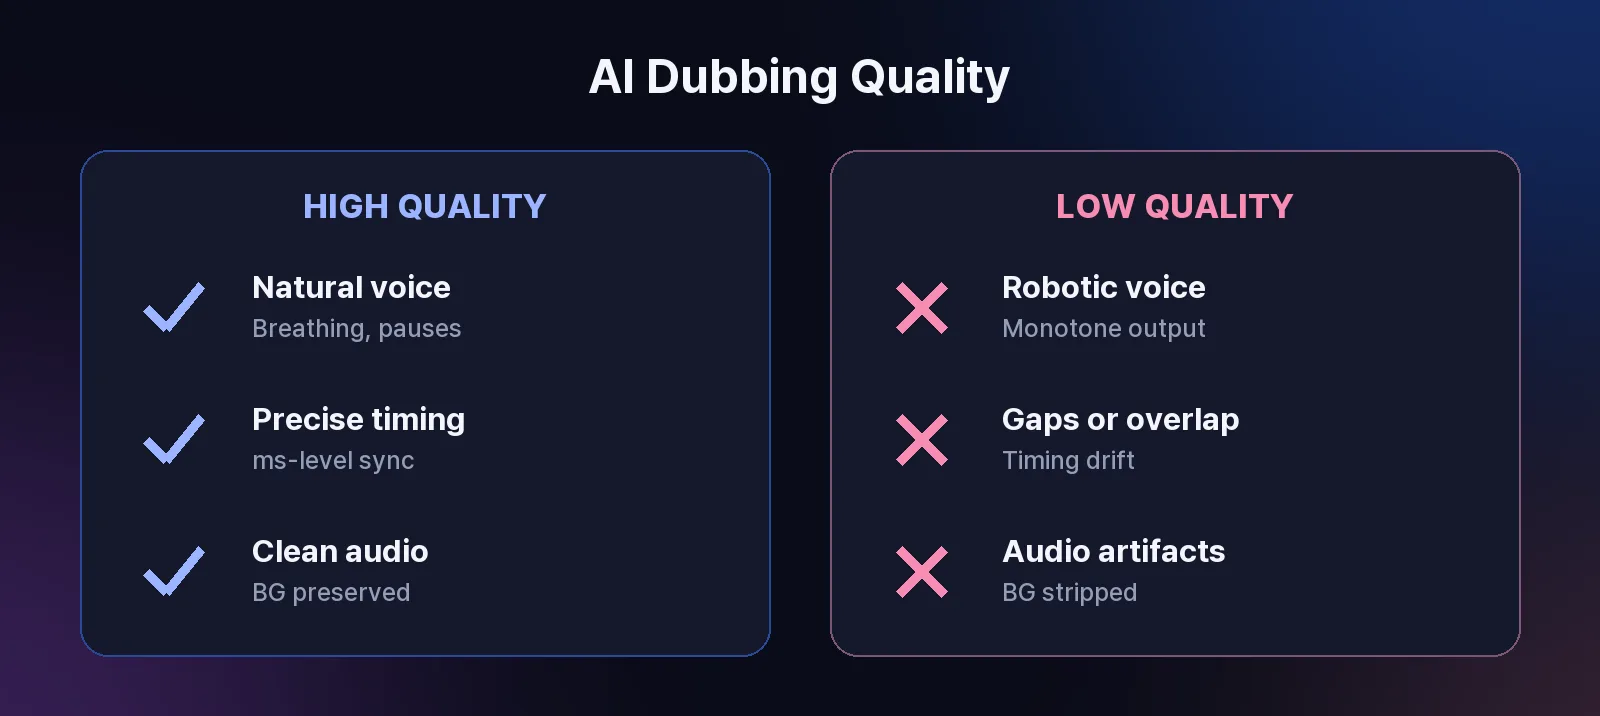
1. ความเป็นธรรมชาติของเสียง ระบบคุณภาพต่ำสร้างเอาต์พุตที่ฟังดูเป็นหุ่นยนต์หรือราบเรียบ เอนจินคุณภาพสูงอย่าง ElevenLabs V3 สร้างเสียงพูดที่มีจังหวะเป็นธรรมชาติ รูปแบบการหายใจ และจังหวะหยุดเล็กน้อยที่ฟังดูเหมือนมนุษย์
2. ความแม่นยำของจังหวะ จังหวะที่ไม่ดีสร้างช่องว่างที่น่าอึดอัดหรือเสียงทับซ้อน ไปป์ไลน์ขั้นสูงปรับอัตราการพูดและตำแหน่งหยุดแบบไดนามิกให้ตรงกับจังหวะวิดีโอต้นฉบับในระดับมิลลิวินาที
3. การรักษาเสียงพื้นหลัง เครื่องมือพื้นฐานมักลบเสียงพื้นหลังทั้งหมดหรือสร้างสิ่งแปลกปลอมเมื่อแยกเสียงร้อง แพลตฟอร์มระดับโปรดักชันรักษาซาวด์แทร็กต้นฉบับและผสมเสียงพากย์กลับอย่างราบรื่น
4. ความแม่นยำหลายผู้พูด การพากย์ผู้พูดคนเดียวค่อนข้างตรงไปตรงมา ความท้าทายที่แท้จริงคือการรักษาอัตลักษณ์เสียงที่แตกต่างและการเปลี่ยนตาพูดอย่างเป็นธรรมชาติในเนื้อหาหลายผู้พูด เช่น การสัมภาษณ์ พอดแคสต์ หรือการอภิปรายกลุ่ม
5. ความครอบคลุมภาษาและความสม่ำเสมอของคุณภาพ บางแพลตฟอร์มจัดการภาษาหลักได้ดีแต่ให้คุณภาพที่ต่ำลงอย่างเห็นได้ชัดสำหรับคู่ภาษาที่ไม่ค่อยพบ ความสม่ำเสมอของคุณภาพในภาษาที่หลากหลายต้องการข้อมูลการฝึกอบรมที่มากและการเพิ่มประสิทธิภาพโมเดลต่อภาษา
Perso Dubbing ใช้ไปป์ไลน์อย่างไร
Perso Dubbing ย่อไปป์ไลน์ 4 ขั้นตอนให้เป็นเวิร์กโฟลว์ 3 ขั้นตอน:

อัปโหลดวิดีโอของคุณ
เลือกภาษาเป้าหมาย (จากกว่า 99 ภาษาที่มี)
ดาวน์โหลดวิดีโอที่พากย์แล้ว
แพลตฟอร์มจัดการการรู้จำเสียง (100 ภาษาอินพุต) การแปล การสังเคราะห์เสียงด้วย ElevenLabs V3 และการจัดเรียงการซิงค์ปากในการประมวลผลอัตโนมัติครั้งเดียว เวลาประมวลผลเฉลี่ยน้อยกว่า 3 นาทีสำหรับวิดีโอความยาวมาตรฐาน ซึ่งประหยัดเวลาได้ถึง 92% เมื่อเทียบกับเวิร์กโฟลว์การพากย์แบบแมนนวล
กระบวนการทั้งหมดทำงานในเบราว์เซอร์ — ไม่จำเป็นต้องติดตั้งซอฟต์แวร์ ครีเอเตอร์สามารถพากย์หลายภาษาพร้อมกันโดยใช้เครื่องมือ AI dubbing วิดีโอ ทำให้การผลิตเนื้อหาสำหรับผู้ชมทั่วโลกเป็นเรื่องจริงโดยไม่ต้องขยายทีมผลิต หากต้องการดูแพ็กเกจ เริ่มทดลองใช้ฟรีโดยไม่ต้องใช้บัตรเครดิต
อนาคตของเทคโนโลยี AI dubbing
เทคโนโลยี AI dubbing ก้าวหน้าอย่างต่อเนื่องในทั้ง 4 ขั้นตอนของไปป์ไลน์ ทิศทางการวิจัยปัจจุบันรวมถึง:
การพากย์แบบเรียลไทม์สำหรับไลฟ์สตรีมและวิดีโอคอล
โมเดลที่ปรับตามอารมณ์ที่ตรวจจับและถ่ายโอนความละเอียดอ่อนทางอารมณ์ได้แม่นยำยิ่งขึ้น
การแยกผู้พูดที่ดีขึ้นสำหรับสภาพแวดล้อมหลายผู้พูดที่ซับซ้อน เช่น การอภิปรายในงานสัมมนา
การปรับตัวทางวัฒนธรรมนอกเหนือจากการแปล — ปรับอารมณ์ขัน การอ้างอิง และสำนวนให้เหมาะกับผู้ชมท้องถิ่น
เมื่อความสามารถเหล่านี้เติบโตขึ้น ช่องว่างระหว่างเนื้อหาที่พากย์ด้วย AI และเนื้อหาที่พากย์โดยมนุษย์มืออาชีพก็แคบลงเรื่อยๆ ขณะที่ข้อได้เปรียบด้านความเร็วและต้นทุนของ AI dubbing เพิ่มขึ้น
คำถามที่พบบ่อย
ถ. AI dubbing ทำงานอย่างไร? ต. AI dubbing ทำงานผ่านไปป์ไลน์อัตโนมัติ 4 ขั้นตอน ขั้นแรก การรู้จำเสียงแปลงเสียงต้นฉบับเป็นข้อความ จากนั้น การแปลด้วยเครื่องแบบนิวรอลแปลงข้อความเป็นภาษาเป้าหมายพร้อมรักษาจังหวะการพูดที่เป็นธรรมชาติ การสังเคราะห์เสียงสร้างเสียงพูดใหม่โดยใช้เสียงโคลนของผู้พูดดั้งเดิม สุดท้าย การจัดเรียงการซิงค์ปากปรับการขยับปากให้ตรงกับเสียงใหม่ แพลตฟอร์มอย่าง Perso Dubbing ทำกระบวนการทั้งหมดนี้เสร็จภายในประมาณ 3 นาที
ถ. AI dubbing ใช้เวลานานเท่าไหร่เมื่อเทียบกับการพากย์แบบดั้งเดิม? ต. แพลตฟอร์ม AI dubbing อย่าง Perso Dubbing ประมวลผลวิดีโอเฉลี่ย 3 นาที เทียบกับหลายวันหรือหลายสัปดาห์สำหรับการพากย์ในสตูดิโอแบบดั้งเดิม ซึ่งประหยัดเวลาได้ถึง 92% ความแตกต่างด้านความเร็วมาจากการทำให้ทั้ง 4 ขั้นตอนของไปป์ไลน์เป็นอัตโนมัติ — การถอดเสียง การแปล การสังเคราะห์เสียง และการซิงค์ปาก — ซึ่งแบบดั้งเดิมต้องการทีมและเซสชันแยกกัน
ถ. AI dubbing สามารถรักษาเสียงของผู้พูดดั้งเดิมได้หรือไม่? ต. ได้ AI dubbing สมัยใหม่ใช้เทคโนโลยีโคลนเสียงเพื่อวิเคราะห์คุณลักษณะเสียงของผู้พูดดั้งเดิม — ระดับเสียง สีสันเสียง จังหวะ และโทนอารมณ์ — จากนั้นสร้างเสียงพากย์ที่ฟังดูเหมือนคนเดิมพูดภาษาอื่น Perso Dubbing ใช้ ElevenLabs V3 สำหรับการสังเคราะห์เสียง ซึ่งรักษาอัตลักษณ์เสียงในกว่า 99 ภาษาเป้าหมาย
ถ. ความแตกต่างระหว่าง AI dubbing กับการแปลวิดีโอด้วย AI คืออะไร? ต. การแปลวิดีโอด้วย AI เป็นหมวดหมู่ที่กว้างกว่าซึ่งรวมถึงการใส่คำบรรยาย การพากย์ทับ และการพากย์ AI dubbing แทนที่เสียงพูดต้นฉบับด้วยเสียงที่สังเคราะห์ในภาษาอื่นโดยเฉพาะ รวมถึงการโคลนเสียงและการจัดเรียงการซิงค์ปาก สร้างประสบการณ์การรับชมที่ดื่มด่ำมากกว่าคำบรรยายเพียงอย่างเดียว เนื่องจากผู้ชมได้ยินเนื้อหาในภาษาแม่ของตนโดยไม่ต้องอ่านข้อความบนหน้าจอ
Taeksoon Kwon เป็นผู้อำนวยการของ Perso AI ดูแลสแต็กเทคโนโลยี AI dubbing และไปป์ไลน์การสังเคราะห์เสียงที่ Perso Dubbing
AI dubbing แปลงเสียงวิดีโอจากภาษาหนึ่งเป็นอีกภาษาหนึ่งผ่านไปป์ไลน์ 4 ขั้นตอน: การรู้จำเสียง การแปลด้วยนิวรอล การสังเคราะห์เสียง และการจัดเรียงการซิงค์ปาก แพลตฟอร์มอย่าง Perso Dubbing ทำกระบวนการนี้เสร็จภายในประมาณ 3 นาที แทนที่เวิร์กโฟลว์แบบดั้งเดิมที่ใช้เวลาหลายวันหรือหลายสัปดาห์กับนักพากย์ วิศวกรเสียง และทีมโพสต์โปรดักชัน
บทความนี้อธิบายแต่ละขั้นตอนของไปป์ไลน์ AI dubbing อธิบายเทคโนโลยีที่ขับเคลื่อนมัน และแสดงให้เห็นว่าความแตกต่างด้านคุณภาพเกิดขึ้นที่ไหนระหว่างเครื่องมือต่างๆ
จากสตูดิโอแบบแมนนวลสู่ไปป์ไลน์อัตโนมัติ
การพากย์แบบดั้งเดิมต้องจ้างนักพากย์สำหรับทุกภาษาเป้าหมาย จัดเซสชันบันทึกเสียงในสตูดิโอเก็บเสียง ปรับจังหวะด้วยมือให้ตรงกับการขยับปาก และผสมเสียงขั้นสุดท้ายอย่างละเอียด วิดีโอ 10 นาทีเพียงชิ้นเดียวที่พากย์เป็น 5 ภาษาอาจใช้เวลา 2-4 สัปดาห์และมีค่าใช้จ่ายหลายพันดอลลาร์
AI dubbing แทนที่สิ่งนี้ด้วยไปป์ไลน์อัตโนมัติที่จัดการทั้ง 4 ขั้นตอน — การถอดเสียง การแปล การสร้างเสียง และการซิงค์ปาก — ในการประมวลผลครั้งเดียว ผลลัพธ์คือวิดีโอที่พากย์แล้วซึ่งรักษาคุณลักษณะเสียงของผู้พูดดั้งเดิม ทำให้ครีเอเตอร์สามารถแปลวิดีโอเป็นกว่า 99 ภาษาจากการอัปโหลดเพียงครั้งเดียว
สำหรับภาพรวมที่กว้างขึ้นเกี่ยวกับ AI dubbing คืออะไรและควรใช้เมื่อไหร่ ดูคู่มือ AI dubbing ฉบับสมบูรณ์ของเรา
ไปป์ไลน์ AI dubbing 4 ขั้นตอน
แพลตฟอร์ม AI dubbing ทุกแห่งใช้สถาปัตยกรรมพื้นฐานเดียวกัน แม้ว่าการใช้งานจริงจะแตกต่างกันในด้านคุณภาพและความสามารถ ต่อไปนี้คือวิธีการทำงานของแต่ละขั้นตอน
ขั้นตอนที่ 1: การรู้จำเสียง (ASR / STT)
ไปป์ไลน์เริ่มต้นด้วยการรู้จำเสียงอัตโนมัติ (ASR) หรือที่เรียกว่า speech-to-text (STT) ขั้นตอนนี้แปลงแทร็กเสียงต้นฉบับเป็นข้อความที่มีการประทับเวลา
สิ่งที่เกิดขึ้นในทางเทคนิค:
เสียงถูกแยกออกจากเพลงประกอบและเอฟเฟกต์เสียงโดยใช้อัลกอริทึมแยกแหล่งที่มา (การแยกเสียงร้อง)
โมเดลรู้จำเสียงถอดคำพูดเป็นข้อความ รองรับสำเนียง ภาษาถิ่น และศัพท์เฉพาะทาง
การแยกผู้พูด (diarization) ระบุและติดป้ายผู้พูดต่างๆ ในวิดีโอหลายผู้พูด
แต่ละคำหรือวลีได้รับการประทับเวลาที่แม่นยำ รักษาจังหวะต้นฉบับ
ทำไมจึงสำคัญต่อคุณภาพ: ข้อผิดพลาดในขั้นตอนนี้ส่งผลกระทบเป็นลูกโซ่ตลอดทั้งไปป์ไลน์ คำที่ถอดเสียงผิดกลายเป็นประโยคที่แปลผิด ซึ่งกลายเป็นเสียงพากย์ที่ไม่ถูกต้อง เอนจินรู้จำเสียงของ Perso Dubbing รองรับ 100 ภาษาเป็นอินพุต หมายความว่าแทบทุกภาษาต้นทางสามารถเข้าสู่ไปป์ไลน์ได้
ขั้นตอนที่ 2: การแปลด้วยเครื่องแบบนิวรอล (NMT)
ข้อความที่ถอดเสียงพร้อมประทับเวลาจะเข้าสู่ขั้นตอนการแปล ซึ่งโมเดลการแปลด้วยเครื่องแบบนิวรอลจะแปลงข้อความเป็นภาษาเป้าหมาย
อะไรที่ทำให้การแปลสำหรับพากย์แตกต่างจากการแปลข้อความ:
การจับคู่ความยาว: ประโยคที่แปลแล้วต้องมีระยะเวลาใกล้เคียงกับคำพูดต้นฉบับ วลีภาษาอังกฤษ 3 วินาทีที่แปลเป็นภาษาเยอรมันอาจใช้เวลาพูด 5 วินาที — โมเดลแปลต้องบีบอัดหรือปรับโครงสร้างใหม่ให้พอดี
ความเหมาะสมในการพูด: การแปลแบบเขียนมักฟังดูไม่เป็นธรรมชาติเมื่ออ่านออกเสียง โมเดล NMT ที่ปรับให้เหมาะกับการพากย์จะสร้างเอาต์พุตแบบสนทนาที่เหมาะสำหรับการสังเคราะห์เสียง
การรักษาบริบท: คำศัพท์เทคนิค ชื่อเฉพาะ และการอ้างอิงทางวัฒนธรรมต้องการการจัดการที่รักษาความหมายโดยไม่ใช้การแปลคำต่อคำแบบตรงตัว
การจัดเรียงประทับเวลา: แต่ละเซกเมนต์ที่แปลแล้วจะสืบทอดข้อจำกัดด้านเวลาจากต้นฉบับ เพื่อให้แน่ใจว่าเสียงพากย์ตรงกับสัญญาณภาพบนหน้าจอ
แพลตฟอร์ม AI dubbing สมัยใหม่ใช้โมเดลภาษาขนาดใหญ่ที่ปรับแต่งเฉพาะสำหรับการแปลภาษาพูด ไม่ใช่ตัวแปลข้อความแบบทั่วไป ความแตกต่างนี้สำคัญมากสำหรับเอาต์พุตที่ฟังดูเป็นธรรมชาติ
ขั้นตอนที่ 3: การสังเคราะห์และโคลนเสียง (TTS)
ขั้นตอนนี้คือจุดที่ข้อความที่แปลแล้วกลายเป็นเสียงพูด เอนจิน text-to-speech (TTS) สร้างเสียงพูดในภาษาเป้าหมายพร้อมรักษาคุณลักษณะเสียงของผู้พูดดั้งเดิม
เทคโนโลยีเบื้องหลังการรักษาเสียง:
การโคลนเสียง: ระบบวิเคราะห์เสียงของผู้พูดดั้งเดิม — ระดับเสียง สีสันเสียง จังหวะการพูด และโทนอารมณ์ — จากนั้นสร้างเสียงพูดใหม่ที่ฟังดูเหมือนคนเดิมพูดภาษาอื่น
การถ่ายโอนทำนองเสียง: นอกเหนือจากเสียงพูดแล้ว ระบบยังถ่ายโอนรูปแบบการพูด: การเน้น จังหวะหยุด เส้นโค้งทำนองเสียง และความเร็ว
การจับคู่อารมณ์: โมเดลขั้นสูงตรวจจับสถานะอารมณ์ในเสียงต้นทาง (ความตื่นเต้น ความกังวล อารมณ์ขัน) และจำลองมันในเอาต์พุตที่สังเคราะห์
Perso Dubbing ใช้ ElevenLabs V3 เอนจินสังเคราะห์เสียงที่สร้างเสียงพูดที่ฟังดูเป็นธรรมชาติพร้อมรักษาอัตลักษณ์เสียงของผู้พูดดั้งเดิม ผู้ใช้สามารถปรับแต่งเอาต์พุตเพิ่มเติมผ่านตัวเลือก VoiceTone ซึ่งช่วยให้ครีเอเตอร์ปรับแต่งคุณลักษณะโทนเสียงอย่างละเอียดสำหรับประเภทเนื้อหาเฉพาะ — ไม่ว่าจะเป็นบรรยายด้านการศึกษา วิดีโอการตลาด หรือเนื้อหาบันเทิง
การจัดการหลายผู้พูด: ในวิดีโอที่มีผู้พูดหลายคน แต่ละเสียงจะถูกโคลนและสังเคราะห์แยกกัน ไปป์ไลน์รักษาโปรไฟล์เสียงที่แตกต่างกันตลอดทั้งกระบวนการ ดังนั้นการสนทนาระหว่างสองคนจะฟังดูเหมือนคนสองคนในเวอร์ชันที่พากย์แล้ว
ขั้นตอนที่ 4: การจัดเรียงการซิงค์ปาก
ขั้นตอนสุดท้ายจัดการกับความสอดคล้องของภาพ เมื่อเสียงพากย์มีความยาวหรือจังหวะแตกต่างจากต้นฉบับ การขยับปากของผู้พูดจะไม่ตรงกับสิ่งที่ผู้ชมได้ยินอีกต่อไป
เทคโนโลยีซิงค์ปากทำงานอย่างไร:
โมเดล computer vision วิเคราะห์การเคลื่อนไหวใบหน้าของผู้พูดทีละเฟรม ระบุรูปทรงปาก (visemes) และจังหวะ
ระบบปรับจังหวะเสียงที่สังเคราะห์ให้ตรงกับการขยับปากที่มีอยู่ หรือปรับเปลี่ยนบริเวณใบหน้าของวิดีโอให้ตรงกับเสียงใหม่
เสียงพื้นหลัง (เพลง เสียงแวดล้อม เอฟเฟกต์) ถูกรักษาไว้และผสมกลับเข้ากับแทร็กเสียงพากย์
Perso Dubbing ประมวลผลการพากย์พร้อมซิงค์ปากโดยอัตโนมัติเป็นส่วนหนึ่งของเวิร์กโฟลว์การพากย์ — ไม่มีขั้นตอนแยกหรือค่าใช้จ่ายเพิ่มเติม นี่เป็นจุดแตกต่างที่สำคัญ เนื่องจากบางแพลตฟอร์มเรียกเก็บค่าใช้จ่ายเพิ่มสำหรับการประมวลผลซิงค์ปากหรือไม่มีให้บริการเลย สำหรับคู่มือเชิงลึกเกี่ยวกับการทำซิงค์ปากให้เป็นธรรมชาติ ดูคู่มือของเราเกี่ยวกับวิธีทำซิงค์ปากที่สมบูรณ์แบบด้วย AI dubbing
อะไรที่แยก AI dubbing ที่ดีจากที่แย่
ไม่ใช่ทุกไปป์ไลน์ AI dubbing จะให้ผลลัพธ์เท่ากัน ความแตกต่างด้านคุณภาพมักปรากฏใน 5 ด้าน:
1. ความเป็นธรรมชาติของเสียง ระบบคุณภาพต่ำสร้างเอาต์พุตที่ฟังดูเป็นหุ่นยนต์หรือราบเรียบ เอนจินคุณภาพสูงอย่าง ElevenLabs V3 สร้างเสียงพูดที่มีจังหวะเป็นธรรมชาติ รูปแบบการหายใจ และจังหวะหยุดเล็กน้อยที่ฟังดูเหมือนมนุษย์
2. ความแม่นยำของจังหวะ จังหวะที่ไม่ดีสร้างช่องว่างที่น่าอึดอัดหรือเสียงทับซ้อน ไปป์ไลน์ขั้นสูงปรับอัตราการพูดและตำแหน่งหยุดแบบไดนามิกให้ตรงกับจังหวะวิดีโอต้นฉบับในระดับมิลลิวินาที
3. การรักษาเสียงพื้นหลัง เครื่องมือพื้นฐานมักลบเสียงพื้นหลังทั้งหมดหรือสร้างสิ่งแปลกปลอมเมื่อแยกเสียงร้อง แพลตฟอร์มระดับโปรดักชันรักษาซาวด์แทร็กต้นฉบับและผสมเสียงพากย์กลับอย่างราบรื่น
4. ความแม่นยำหลายผู้พูด การพากย์ผู้พูดคนเดียวค่อนข้างตรงไปตรงมา ความท้าทายที่แท้จริงคือการรักษาอัตลักษณ์เสียงที่แตกต่างและการเปลี่ยนตาพูดอย่างเป็นธรรมชาติในเนื้อหาหลายผู้พูด เช่น การสัมภาษณ์ พอดแคสต์ หรือการอภิปรายกลุ่ม
5. ความครอบคลุมภาษาและความสม่ำเสมอของคุณภาพ บางแพลตฟอร์มจัดการภาษาหลักได้ดีแต่ให้คุณภาพที่ต่ำลงอย่างเห็นได้ชัดสำหรับคู่ภาษาที่ไม่ค่อยพบ ความสม่ำเสมอของคุณภาพในภาษาที่หลากหลายต้องการข้อมูลการฝึกอบรมที่มากและการเพิ่มประสิทธิภาพโมเดลต่อภาษา
Perso Dubbing ใช้ไปป์ไลน์อย่างไร
Perso Dubbing ย่อไปป์ไลน์ 4 ขั้นตอนให้เป็นเวิร์กโฟลว์ 3 ขั้นตอน:
อัปโหลดวิดีโอของคุณ
เลือกภาษาเป้าหมาย (จากกว่า 99 ภาษาที่มี)
ดาวน์โหลดวิดีโอที่พากย์แล้ว
แพลตฟอร์มจัดการการรู้จำเสียง (100 ภาษาอินพุต) การแปล การสังเคราะห์เสียงด้วย ElevenLabs V3 และการจัดเรียงการซิงค์ปากในการประมวลผลอัตโนมัติครั้งเดียว เวลาประมวลผลเฉลี่ยน้อยกว่า 3 นาทีสำหรับวิดีโอความยาวมาตรฐาน ซึ่งประหยัดเวลาได้ถึง 92% เมื่อเทียบกับเวิร์กโฟลว์การพากย์แบบแมนนวล
กระบวนการทั้งหมดทำงานในเบราว์เซอร์ — ไม่จำเป็นต้องติดตั้งซอฟต์แวร์ ครีเอเตอร์สามารถพากย์หลายภาษาพร้อมกันโดยใช้เครื่องมือ AI dubbing วิดีโอ ทำให้การผลิตเนื้อหาสำหรับผู้ชมทั่วโลกเป็นเรื่องจริงโดยไม่ต้องขยายทีมผลิต หากต้องการดูแพ็กเกจ เริ่มทดลองใช้ฟรีโดยไม่ต้องใช้บัตรเครดิต
อนาคตของเทคโนโลยี AI dubbing
เทคโนโลยี AI dubbing ก้าวหน้าอย่างต่อเนื่องในทั้ง 4 ขั้นตอนของไปป์ไลน์ ทิศทางการวิจัยปัจจุบันรวมถึง:
การพากย์แบบเรียลไทม์สำหรับไลฟ์สตรีมและวิดีโอคอล
โมเดลที่ปรับตามอารมณ์ที่ตรวจจับและถ่ายโอนความละเอียดอ่อนทางอารมณ์ได้แม่นยำยิ่งขึ้น
การแยกผู้พูดที่ดีขึ้นสำหรับสภาพแวดล้อมหลายผู้พูดที่ซับซ้อน เช่น การอภิปรายในงานสัมมนา
การปรับตัวทางวัฒนธรรมนอกเหนือจากการแปล — ปรับอารมณ์ขัน การอ้างอิง และสำนวนให้เหมาะกับผู้ชมท้องถิ่น
เมื่อความสามารถเหล่านี้เติบโตขึ้น ช่องว่างระหว่างเนื้อหาที่พากย์ด้วย AI และเนื้อหาที่พากย์โดยมนุษย์มืออาชีพก็แคบลงเรื่อยๆ ขณะที่ข้อได้เปรียบด้านความเร็วและต้นทุนของ AI dubbing เพิ่มขึ้น
คำถามที่พบบ่อย
ถ. AI dubbing ทำงานอย่างไร? ต. AI dubbing ทำงานผ่านไปป์ไลน์อัตโนมัติ 4 ขั้นตอน ขั้นแรก การรู้จำเสียงแปลงเสียงต้นฉบับเป็นข้อความ จากนั้น การแปลด้วยเครื่องแบบนิวรอลแปลงข้อความเป็นภาษาเป้าหมายพร้อมรักษาจังหวะการพูดที่เป็นธรรมชาติ การสังเคราะห์เสียงสร้างเสียงพูดใหม่โดยใช้เสียงโคลนของผู้พูดดั้งเดิม สุดท้าย การจัดเรียงการซิงค์ปากปรับการขยับปากให้ตรงกับเสียงใหม่ แพลตฟอร์มอย่าง Perso Dubbing ทำกระบวนการทั้งหมดนี้เสร็จภายในประมาณ 3 นาที
ถ. AI dubbing ใช้เวลานานเท่าไหร่เมื่อเทียบกับการพากย์แบบดั้งเดิม? ต. แพลตฟอร์ม AI dubbing อย่าง Perso Dubbing ประมวลผลวิดีโอเฉลี่ย 3 นาที เทียบกับหลายวันหรือหลายสัปดาห์สำหรับการพากย์ในสตูดิโอแบบดั้งเดิม ซึ่งประหยัดเวลาได้ถึง 92% ความแตกต่างด้านความเร็วมาจากการทำให้ทั้ง 4 ขั้นตอนของไปป์ไลน์เป็นอัตโนมัติ — การถอดเสียง การแปล การสังเคราะห์เสียง และการซิงค์ปาก — ซึ่งแบบดั้งเดิมต้องการทีมและเซสชันแยกกัน
ถ. AI dubbing สามารถรักษาเสียงของผู้พูดดั้งเดิมได้หรือไม่? ต. ได้ AI dubbing สมัยใหม่ใช้เทคโนโลยีโคลนเสียงเพื่อวิเคราะห์คุณลักษณะเสียงของผู้พูดดั้งเดิม — ระดับเสียง สีสันเสียง จังหวะ และโทนอารมณ์ — จากนั้นสร้างเสียงพากย์ที่ฟังดูเหมือนคนเดิมพูดภาษาอื่น Perso Dubbing ใช้ ElevenLabs V3 สำหรับการสังเคราะห์เสียง ซึ่งรักษาอัตลักษณ์เสียงในกว่า 99 ภาษาเป้าหมาย
ถ. ความแตกต่างระหว่าง AI dubbing กับการแปลวิดีโอด้วย AI คืออะไร? ต. การแปลวิดีโอด้วย AI เป็นหมวดหมู่ที่กว้างกว่าซึ่งรวมถึงการใส่คำบรรยาย การพากย์ทับ และการพากย์ AI dubbing แทนที่เสียงพูดต้นฉบับด้วยเสียงที่สังเคราะห์ในภาษาอื่นโดยเฉพาะ รวมถึงการโคลนเสียงและการจัดเรียงการซิงค์ปาก สร้างประสบการณ์การรับชมที่ดื่มด่ำมากกว่าคำบรรยายเพียงอย่างเดียว เนื่องจากผู้ชมได้ยินเนื้อหาในภาษาแม่ของตนโดยไม่ต้องอ่านข้อความบนหน้าจอ
Taeksoon Kwon เป็นผู้อำนวยการของ Perso AI ดูแลสแต็กเทคโนโลยี AI dubbing และไปป์ไลน์การสังเคราะห์เสียงที่ Perso Dubbing
อ่านต่อ
เรียกดูทั้งหมด